
Embedding dalam Sistem Pencarian Semantik
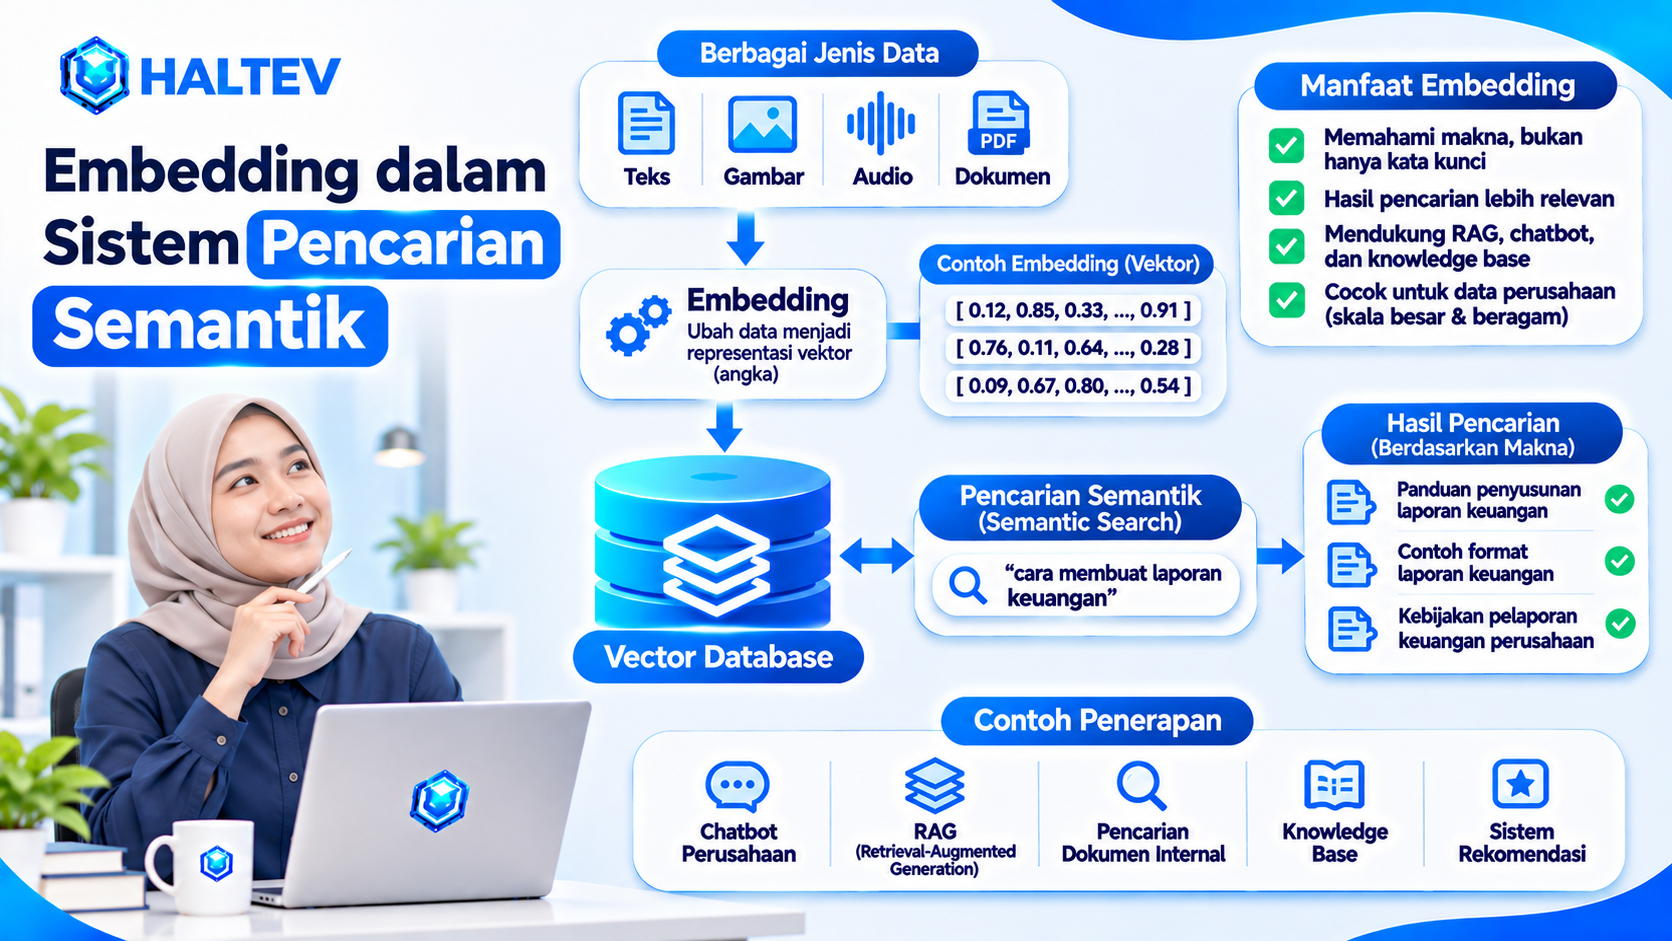
Kemajuan teknologi kecerdasan buatan (Artificial Intelligence/AI) telah membuka berbagai kemungkinan baru dalam dunia pekerjaan, pengembangan produk, pengolahan informasi, dan pendidikan. Salah satu teknologi yang berperan penting dalam pengembangan sistem pencarian modern adalah Embedding. Teknologi ini memungkinkan komputer memahami hubungan makna di antara berbagai informasi sehingga proses pencarian tidak hanya bergantung pada kecocokan kata, tetapi juga mempertimbangkan konteks dan kesamaan makna.
Mempelajari Embedding dalam Sistem Pencarian Semantik bukan sekadar mengenal teknologi yang sedang berkembang. Pemahaman yang baik juga mencakup fungsi, permasalahan yang dapat diselesaikan, keterbatasan penerapan, serta cara memanfaatkan teknologi tersebut secara tepat dan bertanggung jawab.
Memahami Konsep dan Tujuan Embedding dalam Sistem Pencarian Semantik
Embedding merupakan proses mengubah informasi, seperti teks, gambar, atau jenis data lainnya, menjadi representasi numerik berbentuk vektor. Representasi tersebut memungkinkan sistem komputer mengidentifikasi hubungan dan kemiripan antara satu informasi dengan informasi lainnya.
Dalam sistem pencarian semantik, Embedding digunakan untuk membantu mesin memahami makna dari suatu kata, kalimat, atau dokumen. Dengan pendekatan ini, hasil pencarian dapat mempertimbangkan kesamaan konteks meskipun pengguna menggunakan istilah yang berbeda dari informasi yang tersimpan.
Sebelum menerapkan teknologi tersebut, tentukan terlebih dahulu kebutuhan dan permasalahan yang ingin diselesaikan. Ruang lingkup penggunaan, karakteristik pengguna, jenis data, serta hasil yang diharapkan perlu diperjelas agar implementasi berjalan sesuai tujuan.
Keputusan teknis juga harus mempertimbangkan skala penggunaan dan kondisi organisasi. Pendekatan yang sesuai untuk proyek sederhana belum tentu efektif ketika diterapkan pada sistem dengan banyak pengguna, informasi sensitif, atau kebutuhan integrasi yang lebih kompleks.
Cara Kerja dan Komponen Utama
Proses pencarian semantik umumnya dimulai dengan mengubah data menjadi representasi vektor menggunakan model Embedding. Setiap teks atau dokumen yang diproses akan menghasilkan kumpulan angka yang merepresentasikan karakteristik maknanya.
Vektor tersebut kemudian digunakan untuk membandingkan kemiripan antara pertanyaan pengguna dan informasi yang tersedia. Pengukuran kemiripan dapat dilakukan menggunakan metode tertentu, seperti Cosine Similarity, sehingga sistem dapat menemukan informasi yang memiliki kedekatan makna dengan permintaan pengguna.
Beberapa komponen yang perlu diperhatikan dalam penerapannya meliputi:
Data atau Dokumen: Informasi yang akan diproses dan digunakan sebagai sumber pencarian.
Embedding Model: Model yang bertugas mengubah data menjadi representasi vektor.
Vector Database: Tempat menyimpan dan mengelola representasi vektor agar dapat digunakan dalam proses pencarian.
Similarity Search: Mekanisme untuk menemukan vektor yang memiliki tingkat kemiripan dengan permintaan pengguna.
Sistem Pencarian: Bagian aplikasi yang menghubungkan masukan pengguna dengan proses pencarian dan menampilkan hasil yang relevan.
Persiapan implementasi perlu diawali dengan penentuan tujuan yang terukur, ketersediaan data, lingkungan pengembangan, serta pembagian tanggung jawab dalam tim. Dokumentasi kondisi awal juga penting agar perubahan dan hasil penerapan dapat dibandingkan secara objektif.
Pemilihan tools sebaiknya disesuaikan dengan kebutuhan teknis dan kemampuan tim. Sebelum menggunakan suatu teknologi, periksa dokumentasi resmi, kompatibilitas versi, batas penggunaan, biaya, kebijakan privasi, serta ketersediaan dukungan teknis. Hindari menambahkan komponen yang belum diperlukan hanya karena tersedia.
Contoh Penerapan dalam Aktivitas Nyata
Salah satu penggunaan Embedding yang cukup umum ditemukan adalah sistem pencarian dokumen berbasis makna. Melalui pendekatan ini, pengguna dapat menemukan informasi berdasarkan konteks pertanyaan tanpa harus mengetikkan kata kunci yang sama persis dengan isi dokumen.
Sebagai contoh, sebuah perusahaan memiliki banyak dokumen internal yang berisi informasi mengenai prosedur kerja, kebijakan, dan panduan operasional. Dengan memanfaatkan Embedding, setiap dokumen dapat diubah menjadi representasi vektor dan disimpan dalam Vector Database. Ketika karyawan mengajukan pertanyaan, sistem akan mencari dokumen yang memiliki kemiripan makna dengan pertanyaan tersebut.
Pengembangan solusi sebaiknya dilakukan melalui tahapan kecil agar setiap proses dapat diperiksa dengan mudah. Buat rancangan awal, gunakan data uji atau dokumen publik, jalankan pengujian, kemudian catat hasil yang diperoleh. Apabila ditemukan informasi yang kurang relevan, lakukan penyesuaian pada data, model, atau mekanisme pencarian.
Penilaian terhadap hasil implementasi juga membutuhkan indikator keberhasilan yang jelas. Beberapa aspek yang dapat digunakan meliputi kecepatan pencarian, relevansi hasil, tingkat kesalahan, kemudahan penggunaan, dan pencapaian target bisnis. Perbandingan dengan sumber informasi asli diperlukan untuk memastikan hasil pencarian sesuai dengan konteks yang dibutuhkan.
Lorem ipsum dolor sit amet, consectetur adipiscing elit. Ut elit tellus, luctus nec ullamcorper mattis, pulvinar dapibus leo.
Langkah Memulai Secara Bertahap
Bagi pemula yang ingin mempelajari Embedding dalam Sistem Pencarian Semantik, langkah awal dapat dimulai dengan menentukan proyek sederhana. Misalnya, membuat aplikasi yang mampu mencari informasi dari sekumpulan dokumen berdasarkan pertanyaan pengguna.
Sebelum proses pengembangan dimulai, tentukan beberapa hal berikut:
Menentukan tujuan: Identifikasi masalah yang ingin diselesaikan melalui sistem pencarian semantik.
Menyiapkan data: Kumpulkan dokumen atau informasi yang relevan dan pastikan kualitasnya memadai.
Memilih model Embedding: Gunakan model yang sesuai dengan jenis data, bahasa, dan kebutuhan aplikasi.
Menyimpan representasi vektor: Kelola hasil Embedding menggunakan penyimpanan yang mendukung pencarian vektor.
Membangun mekanisme pencarian: Hubungkan masukan pengguna dengan proses pencarian berdasarkan kemiripan vektor.
Melakukan pengujian: Periksa relevansi hasil menggunakan berbagai contoh pertanyaan dan dokumen.
Melakukan evaluasi: Perbaiki bagian yang belum sesuai berdasarkan hasil pengujian.
Seluruh keputusan teknis dan hasil pengujian sebaiknya dicatat dalam dokumentasi proyek. Catatan tersebut dapat membantu anggota tim memahami proses pengembangan, mengetahui alasan pemilihan pendekatan, serta melakukan perbaikan ketika kebutuhan sistem berubah.
Risiko, Evaluasi, dan Praktik Terbaik
Penggunaan Embedding dalam sistem pencarian semantik tetap memiliki sejumlah risiko yang perlu diperhatikan. Kualitas hasil pencarian, misalnya, sangat dipengaruhi oleh kualitas data dan kemampuan model dalam merepresentasikan makna informasi. Data yang tidak lengkap, tidak relevan, atau memiliki konteks yang ambigu dapat menghasilkan pencarian yang kurang sesuai.
Keamanan informasi juga menjadi aspek penting, terutama ketika sistem digunakan untuk mengelola dokumen internal perusahaan. Informasi pribadi dan data rahasia tidak boleh dimasukkan ke layanan AI tanpa persetujuan serta pemeriksaan kebijakan yang berlaku. Pengaturan hak akses dan perlindungan data perlu diterapkan untuk mengurangi risiko penyalahgunaan informasi.
Evaluasi secara berkala diperlukan untuk memastikan sistem tetap berjalan sesuai kebutuhan. Pemeriksaan dapat mencakup relevansi hasil pencarian, perubahan versi model, pembaruan teknologi, dan kendala yang dialami pengguna.
Pada penerapan yang melibatkan informasi penting atau keputusan bisnis, validasi manusia tetap dibutuhkan. Mekanisme pemeriksaan dan koreksi dapat membantu mengurangi dampak kesalahan hasil pencarian serta menjaga kualitas informasi yang digunakan.
FAQ
Apa yang perlu dipahami sebelum mempelajari Embedding dalam Sistem Pencarian Semantik?
Pemahaman awal dapat dimulai dengan mengenal konsep dasar Embedding, representasi vektor, dan cara kerja pencarian semantik. Pengetahuan mengenai pengolahan data serta dasar pemrograman juga dapat membantu proses pembelajaran. Setelah memahami konsep tersebut, cobalah membuat proyek sederhana agar materi lebih mudah dipahami melalui praktik langsung.
Apakah Embedding dalam Sistem Pencarian Semantik cocok dipelajari oleh pemula?
Teknologi ini dapat dipelajari oleh pemula selama prosesnya dilakukan secara bertahap. Mulailah dengan memahami konsep dasar, mempelajari dokumentasi resmi, dan mencoba menggunakan model Embedding yang tersedia. Latihan sederhana menggunakan kumpulan dokumen dapat menjadi langkah awal sebelum mengembangkan aplikasi pencarian yang lebih kompleks.
Bagaimana cara mengetahui penerapan Embedding sudah berhasil?
Keberhasilan penerapan dapat dilihat melalui relevansi hasil pencarian, kecepatan pemrosesan, dan kesesuaian informasi dengan kebutuhan pengguna. Pengujian perlu dilakukan menggunakan berbagai pertanyaan dan sumber data yang realistis. Hasilnya kemudian didokumentasikan dan dibandingkan dengan indikator keberhasilan yang telah ditetapkan sejak awal.
Kesimpulan
Embedding memiliki peran penting dalam pengembangan sistem pencarian semantik karena memungkinkan informasi direpresentasikan dalam bentuk vektor dan dibandingkan berdasarkan kemiripan makna. Teknologi ini dapat membantu aplikasi menemukan informasi yang relevan meskipun kata-kata yang digunakan pengguna berbeda dari isi sumber data.
Penerapan yang efektif membutuhkan pemahaman terhadap konsep dasar, pemilihan model yang sesuai, pengelolaan data, serta mekanisme pencarian yang tepat. Selain kemampuan menggunakan tools, pengembang juga perlu memperhatikan kualitas informasi, keamanan data, keterbatasan sistem, dan evaluasi hasil secara berkala.
Bagi yang ingin memperdalam keterampilan di bidang kecerdasan buatan dan pengembangan aplikasi, Haltev IT Learning Center menyediakan program pembelajaran yang relevan, seperti AI & Data Science Bootcamp, Pelatihan AI untuk Perusahaan, dan Python Programming. Melalui pembelajaran yang terarah, peserta dapat membangun fondasi teknis untuk memahami dan mengembangkan solusi berbasis teknologi AI.
Referensi dan Tautan Pendukung
Google AI — https://ai.google/
IBM Think — https://www.ibm.com/think
Embedding dalam Sistem Pencarian Semantik
Haltev IT Learning Center adalah lembaga training digital berstandar nasional dan internasional yang mengusung konsep AI-Driven Learning Ecosystem. Kami menyediakan pelatihan di bidang Programming/Coding, Data Science, DevOps, IoT, Microsoft Office, dan Digital Marketing yang terintegrasi dengan Artificial Intelligence untuk mendukung kebutuhan industri modern. Setiap peserta dibekali kemampuan praktis seperti AI Productivity Tools, Automation, Prompt Engineering, dan Data-Driven Decision Making dengan kurikulum berbasis Industry 4.0. Didukung instruktur profesional dari industri teknologi, Haltev berkomitmen mencetak talenta siap kerja dengan skill, mindset AI, dan portofolio berbasis proyek nyata.